Cet article fait suite à J'ai créé un modèle d'IA de zéro en un week-end, et il a appris les échecs tout seul, qui raconte la naissance de Philidor.
En août, Philidor s'est posé à 1702 en rapide sur . Un modèle de langage de 142 millions de , entraîné de zéro sur des suites de coups, qui n'a jamais vu un échiquier ni lu une règle, et qui joue en une de 23 millisecondes. Pour un pur prédicteur de coups, c'était déjà beaucoup.
Puis il n'a plus bougé.
Cet article raconte les sept semaines qui ont suivi : tout ce que j'ai essayé pour le faire progresser, dans l'ordre, avec les mesures. Il y a beaucoup plus d'échecs que de réussites, et c'est voulu. Chaque piste abandonnée a éliminé une explication, et c'est l'élimination méthodique qui a fini par montrer où était le vrai problème.
Aujourd'hui, le bot est à 1996 en rapide, 2020 en bullet, 1975 en blitz et 1930 en classique. De +200 à +370 points selon la , avec le même de 142 M.
Chaque affirmation de cet article s'appuie sur une mesure, et chaque mesure est donnée telle qu'elle est sortie de la machine. Pour les lire :
- un écart d' est toujours donné avec son entre crochets, par exemple
+129,9 [+115,8 ; +144,5]; - il est dit quand l'intervalle entier est d'un seul côté de zéro, non significatif (ns) quand il contient zéro ;
- sauf mention contraire, un duel compte plusieurs centaines à plusieurs milliers de parties, , et a été précédé d'un qui devait rendre exactement 50 %.
En une phrase : ni la réflexion dans le flux de , ni l'imitation de , ni plus de données, ni un meilleur corpus, ni une autre architecture n'ont fait gagner un point au 142 M. Ce qui a marché, c'est de regarder comment il perd, puis de lui donner ce qui lui manquait vraiment : un juge et une recherche, construits avec le même transformeur.
1Le point de départ
| Modèle | philidor-142M : 20 couches, d = 768, 142 M de paramètres |
| Données | 3,19 milliards de coups humains, joueurs de 1800 à 2600 Elo |
| Inférence | une passe avant, , 0 |
| Classement Lichess | Rapide 1702, Blitz 1671, Bullet 1646 (206 parties, 9 août) |
Le classement a un peu bougé ensuite (1719 en rapide le 14 août), mais il est resté collé à 1700. Le bot jouait exactement comme un joueur de 1700 : il connaît les règles, il a de l'intuition, et il ne calcule rien.
2Avant tout : un banc d'essai capable de rendre zéro
La première tentative d'amélioration n'était pas une idée brillante mais une question banale : le modèle joue-t-il mieux en prenant toujours son coup préféré (température 0) ou en échantillonnant un peu (0,3) ?
Premier passage, 100 parties par cellule : écart énorme en faveur de 0,3, et j'avais déjà l'explication. Relancé sur 300 parties : l'écart s'évapore. Troisième mesure : l'inverse du premier.
Deux lecteurs m'ont alors signalé, en commentaire d'un post déjà publié, le défaut de mon banc : les ouvertures aléatoires n'étaient pas appariées entre les deux sens de couleur. Chaque partie recevait une ouverture neuve, donc l'avantage du trait se mélangeait au tirage. Le contrôle qui le démasque coûte dix lignes : faire jouer le modèle contre une copie exacte de lui-même. La seule réponse possible est 50,00 %. Mon protocole rendait 41,67 %.
J'ai ensuite trouvé un second défaut tout seul : Stockfish était bridé en temps (50 ms par coup), donc sa force dépendait de la charge de la machine. Il est désormais bridé en .
Le protocole qui a servi pour tout le reste :
- ouvertures appariées : chaque ouverture est jouée deux fois, couleurs inversées ;
- témoin clone avant chaque série importante : il doit rendre 0,500 exactement ;
- Stockfish limité en nœuds, jamais en temps ;
- un écart d'Elo toujours avec son intervalle de confiance à 95 %, et plusieurs centaines de parties (souvent 1 000 à 3 000) ;
- les deux bras d'un A/B sur la même carte graphique (on verra pourquoi plus bas).
Verdict sur la température, 300 parties par cellule : aucun effet. Le reste de l'article n'aurait aucune valeur sans ce banc.
3Piste 1 : grossir (ça marche, mais ça coûte cher et ça plafonne)
C'est ce qui avait fait passer le premier modèle (51 M) au second (142 M) :
142 M contre 51 M, 200 parties, ouvertures appariées
153 victoires, 29 nulles, 18 défaites   score 0,838
écart d'Elo : +284,9  [+234,1 ; +348,3]
+285 Elo pour 18 heures de GPU. C'est l'étalon contre lequel toutes les autres pistes ont été jugées.
Mais ce chiffre mélangeait deux choses : avait 2,8 fois plus de paramètres et 4 fois plus de tokens. J'ai donc refait l'échelle proprement, en entraînant six petits modèles (de 0,5 M à 22 M de paramètres) avec exactement la recette et le budget de run1. Seule la taille change.
| Modèle | Paramètres | Elo contre le 51 M |
|---|---|---|
| p05 | 0,52 M | −564 |
| p1 | 1,01 M | −463 |
| p2 | 2,04 M | −521 |
| p5 | 5,14 M | −363 |
| p10 | 10,5 M | −279 |
| p20 | 22 M | −119 |
| run1 | 51 M | 0 |
Environ 110 Elo par doublement de taille, sans plateau. Pas de petit modèle miraculeux.
Et les données ? J'ai entraîné un 51 M identique à run1 sur quatre mois de parties toutes différentes au lieu de répéter le même mois :
- à budget égal, aucun effet (−8,7 Elo, intervalle qui contient zéro) : répéter quatre fois le même corpus ne coûtait rien ;
- doubler les tokens rapporte +47 Elo, lentement.
Les paramètres sont environ six fois plus rentables que les tokens. Pour gagner +285 Elo par les seules données, il faudrait une centaine de milliards de tokens. Un modèle de 400 M demanderait dix mois de . Le mur n'était pas théorique : c'était de la place disque et des semaines de calcul, pour une centaine de points par doublement.
Deux pistes abandonnées avant même d'être lancées, parce que la vérification préalable les a tuées :
- Sur-échantillonner les finales parce que « le modèle ne joue pas les finales ». Le diagnostic reposait sur une mesure à la mauvaise température et sur une référence implicite de 100 % de fins terminales, alors que 71 % des vraies parties humaines finissent par abandon. Faux diagnostic, quinze heures de calcul évitées.
- Relever le filtre Elo à 2000 ou 2200 pour apprendre de meilleurs joueurs. Mesuré : le corpus aurait été divisé par 2,6 puis par 9, au moment précis où un plus gros modèle avait besoin de plus de données.
4Piste 2 : lui apprendre à réfléchir dans le flux de tokens (cinq échecs)
L'idée à la mode : faire comme les modèles de raisonnement. Le modèle écrit une variante entre deux balises, puis joue.
<bos> e2e4 e7e5 ... <think> t1 t2 t3 t4 </think> coup jouéLa contrainte que je m'étais fixée : ça doit rester un modèle de langage. Une seule génération autorégressive, pas d'arbre, pas d'arbitre externe. Le seul code autour du réseau reste le masque de légalité, appliqué aussi aux coups imaginés.
v1, sur la suite réellement jouée. En écrivant le moteur, j'ai vu le défaut avant de le mesurer : le coup joué est le premier coup de la ligne imaginée, donc produit à partir de l'historique seul. La suite arrive après la décision. C'est une garantie de décoration. Mesuré : le coup joué est la tête de la ligne dans 98 % des cas.
Le taux d'accord avec le modèle d'origine (66,7 %) semblait dire « la réflexion change un coup sur trois ». En partie :
| Configuration | Écart d'Elo contre le modèle d'origine |
|---|---|
| Mêmes poids, sans réflexion | −6,9 [−66 ; +52] |
| Mêmes poids, avec réflexion | −413 |
Les poids ne sont pas abîmés. C'est la procédure de réflexion qui détruit le jeu. L'explication : le chemin « historique → coup » avait reçu 3,19 milliards de tokens, le chemin « historique → <think> → coup » environ 6 millions. Un rapport de 1 à 500. On ne greffe pas un chemin de raisonnement avec un petit fine-tuning.
v2, trois candidats avant de trancher (A a1 a2 <or> B b1 b2 <or> C c1 c2, ordre tiré au hasard) : −241.
v3, entraîné de zéro avec 17 % de délibération dans le corpus, pour supprimer l'asymétrie : −275 avec réflexion, −5 sans. Trois réplications, une seule conclusion : les poids ne sont jamais abîmés, le chemin de raisonnement nuit toujours.
v4, d'échantillons. On ne dicte plus le contenu de la réflexion : on échantillonne huit traces, on garde celles qui améliorent le coup par rapport à la réponse directe. Après RL, la réflexion est enfin causalement active : 46 % des coups diffèrent du mode direct. Face à Stockfish :
| Niveau | Mode direct | Avec délibération |
|---|---|---|
| 1 | 0,331 | 0,113 |
| 2 | 0,237 | 0,081 |
| 3 | 0,119 | 0,075 |
La délibération divise le score par trois, pour trente fois plus de calcul. C'est du raisonnement qui marche, et qui détruit le jeu.
v5, montrer la variante de Stockfish. Si le problème est que le modèle invente sa délibération sans vérité terrain, donnons-lui la vraie : la d'une recherche Stockfish, que play() calculait déjà et jetait (surcoût mesuré : ×1,02). À nombre de pas égal : −120 Elo. Mais le bras réflexion n'avait que 13 % de densité de supervision contre 87 %, donc 6,6 fois moins de cibles. À supervision égale, le résultat s'inverse : +60 à 10,5 M, +246 à 51 M, et le gain grandit avec la taille.
C'est la seule piste de réflexion qui ait tenu. Mais en échelle absolue, ce 51 M réfléchi reste 54 points sous run1 et 339 sous le bot. L'amener au niveau d'un 142 M coûtait 7,3 jours d'entraînement et 5,5 jours d'étiquetage Stockfish. Elle est restée dans le tiroir.
5Piste 3 : anticiper, et le piège de l'auto-affrontement
L'idée suivante était simple : faire jouer quelques coups au modèle, puis regarder le résultat.
Le blocage est dans le vocabulaire : 1968 coups et trois marqueurs, aucun token ne veut dire « bon » ou « mauvais ». On peut poser la question, il n'a aucun symbole pour répondre. Il faut donc lire le jugement ailleurs.
- Simuler jusqu'au mat : le même moteur, sur la même position, jouait autre chose 12 fois sur 20 selon la graine. Pour un signal fiable il fallait ~155 000 évaluations par coup, dix minutes. Le duel n'a pas été lancé : il aurait mesuré du bruit. C'est au passage la démonstration de pourquoi a une tête de valeur : sans elle, le est inabordable.
- Horizon court de 8 , compté au matériel, une seule simulation déterministe par candidat : 262 ms par coup.
anticipation 8 demi-coups contre le modèle nu, 200 parties
score 0,930   écart d'Elo : +449,4  [+379,7 ; +556,8]
+449, puis +552 à 10 demi-coups, +796 à 12. Monotone. J'y ai cru.
Contre Stockfish, même modèle, même échelle :
| Niveau | 142 M nu | Anticipation |
|---|---|---|
| 0 | 0,808 | 0,767 |
| 1 | 0,683 | 0,667 |
| 2 | 0,417 | 0,525 |
Aucun gain aux niveaux 0 et 1. Le +449 était un artefact. Le moteur simule l'avenir avec le même modèle que son adversaire : en , sa projection est une prédiction quasi parfaite de ce que l'adversaire va jouer. Il ne devine pas l'avenir, il le connaît.
Règle que je garde : ne jamais valider par auto-affrontement une méthode dont le fonctionnement modélise l'adversaire. Elle se flatte mécaniquement.
6Piste 4 : imiter un meilleur maître (il apprend, il ne progresse pas)
Diagnostic plausible : le modèle se retrouve dans des positions que ses propres erreurs créent, et qu'aucun bon joueur n'atteint. D'où : il joue, Stockfish niveau 20 corrige, on réentraîne.
| Essai | Corrections | Parties distinctes | Elo |
|---|---|---|---|
| DAgger naïf | 549 000 | 20 000 | −49 |
| Loss masquée sur le préfixe | 549 000 | 20 000 | −63 |
| Une position par partie | 29 000 | 29 000 | +31 (ns) |
| Une position par partie, à grande échelle | 348 000 | 600 000 | −23 (ns) |
Le premier essai avait un vrai défaut (la portait sur ~50 coups du modèle, gaffes comprises, contre un seul coup du maître) mais le corriger n'a rien changé. Le diagnostic est ailleurs : sur les positions corrigées, l'accord avec Stockfish passe de 11 % à 46 %, et sur des positions inédites il ne bouge pas. Le modèle mémorise ses corrections.
À grande échelle, avec une seule position par partie, l'apprentissage généralise enfin : +4,6 points d'accord avec Stockfish sur des positions tenues à l'écart, à 2,9 . Et la force de jeu ne bouge pas.
Faire mieux imiter Stockfish ne rend pas le modèle plus fort. Il joue le bon coup une fois de plus sur vingt, et ne gagne pas une partie de plus.
Pour enfoncer le clou, un A/B complet : mêmes 600 000 parties, mêmes positions, seul le maître change (coup humain ou coup de Stockfish à ~3000 Elo) :
maître Stockfish contre maître humain, 1000 parties
écart d'Elo : −35,9  [−49,8 ; −22,1]   significatif, à l'avantage de l'humain
Un maître dont on ne montre que les conclusions est inutilisable pour un élève qui ne calcule pas : 59 % des cibles moteur sont des coups qu'aucun humain du corpus n'a joués. Un plan cohérent mais modeste vaut mieux qu'un coup fort isolé.
7Piste 5 : changer les données (des gains à petite échelle qui s'évaporent)
Apprendre uniquement les coups du gagnant. Le modèle imite indifféremment les deux camps, donc la moitié de ses exemples viennent du perdant. La partie reste dans le flux, mais la loss ne porte que quand le futur gagnant est au trait.
| Modèle | Elo contre son témoin |
|---|---|
| 51 M | +49,0 [+26,2 ; +72,2], répliqué sur deux graines |
| 142 M | +9,6 [−20,7 ; +39,9], non significatif |
Premier gain solide de l'enquête, pour 1 h 15 de calcul. Et il ne transfère pas au modèle du bot.
au lieu de filtrer. 83,6 % des parties étaient jetées par les filtres Elo et cadence. Idée : tout garder, et préfixer chaque partie de quatre jetons (<eloBlancs> <eloNoirs> <cadence> <issue>), puis demander à l'inférence la condition voulue. À 10,5 M, un « témoin interne » (mêmes poids, avec et sans amorce) donnait +34,7 Elo, puis +137 sur le 142 M entraîné ainsi. J'ai titré « la première hypothèse qui tient ».
C'était faux. Le modèle n'avait jamais vu de séquence sans amorce à l'entraînement : lui retirer son amorce le met . Ce témoin mesurait le coût d'une sortie de distribution, pas l'apport du conditionnement. La seule comparaison valide, deux modèles distincts de 142 M contre run2 : −2,4 et +8,7, tous deux non significatifs.
Un témoin « avec et sans X » n'est valide que si le modèle a vu les deux régimes à l'entraînement.
Le même schéma revient partout : ce qui aide un petit modèle limité par sa capacité n'apporte rien à un modèle qui a déjà extrait l'essentiel du signal.
8Piste 6 : changer l'architecture (trois idées falsifiées)
« Il gaspille sa capacité à reconstruire l'échiquier. » Un réseau convolutif qui reçoit le plateau en entrée atteint une force comparable avec 11 M de paramètres. sur les activations gelées : Philidor retrouve chaque pièce occupée à 91 %. La lecture monte de 42 % (0,5 M) à 90 % (51 M) puis sature. J'en ai d'abord conclu que les paramètres servaient à reconstruire l'échiquier. Puis j'ai testé : une qui force un 10,5 M à lire le plateau le fait passer de 80 % à 92 %, mieux que run1, pour +14,8 Elo non significatifs. La lecture est un symptôme de la capacité, pas son emploi. Corrélation n'est pas causalité, encore.
Le : boucler plusieurs fois dans les mêmes couches au lieu d'écrire des tokens. Un 8,5 M bouclé gagne +190 Elo entre 1 et 8 tours, première fois qu'on mesurait un gain à « réfléchir plus longtemps »… puis s'effondre au-delà. L'optimum tombe exactement sur la moyenne des tours tirés à l'entraînement, et répliqué à 26,7 M : ce n'est pas du calcul qu'on achète à l'inférence. Et en duel direct, 36 couches effectives perdent contre 10 couches réelles (−91 Elo, significatif).
Une tête de valeur auxiliaire qui apprend à dire qui gagne : elle apprend parfaitement son métier, et le modèle joue −47 Elo moins bien (significatif). À petite taille, ce qui part vers la valeur ne va pas au coup.
À ce stade, le tableau de bord était brutal :
| Hypothèse sur le plafond à 1700 | Verdict |
|---|---|
| Le format de raisonnement en tokens | Écarté, jusqu'à −436 Elo contre Stockfish |
| La recherche à l'inférence (anticipation) | Écarté, artefact d'auto-affrontement |
| La distribution d'entraînement (DAgger) | Écarté, généralise sans effet sur l'Elo |
| La connaissance du bon coup | Écarté, +4,6 points d'accord, zéro Elo |
| La diversité du corpus | Écarté, aucun effet à budget égal |
| La représentation de l'échiquier | Écarté, offerte gratuitement, +14,8 ns |
| Le raisonnement latent | Partiel, ne bat pas la taille |
| La capacité | Ce qui restait debout |
9Le déclic : regarder comment il perd
On optimisait depuis des semaines sans avoir jamais regardé comment le bot perdait. Analyse Stockfish de 1 600 de ses parties classées :
=== PERTE MOYENNE PAR COUP (centipions) ===
   phase       défaites   victoires
   ouverture        19          17
   milieu          313         194
   finale          653         283

=== FORME DE LA DÉFAITE ===
  une gaffe fatale (>400 cp)     93,2 %
  une erreur nette (200-400)      5,4 %
  dégradation lente (<200)        1,4 %
93 % des défaites tiennent à un seul coup. Pas une érosion : une unique. Voilà pourquoi améliorer la qualité moyenne n'avait jamais rien donné. La moyenne n'était pas le problème.
Puis un diagnostic ciblé, sur 5 000 positions de milieu de partie jamais vues, avec Stockfish à profondeur 18 sur tous les coups légaux. Quatre mesures avant d'entraîner quoi que ce soit :
- Le taux de gaffes est celui de ses maîtres : 18,3 % de coups perdant ≥ 100 , contre 20,7 % pour les humains de 1800-2600 sur les mêmes positions. Il a rejoint son professeur.
- Le bon coup est proposé, pas choisi : dans 71,5 % des gaffes, le meilleur coup est dans son .
- La représentation est là : une sonde linéaire lit « pièce en prise » à 0,992, contre 1,000 pour le contrôle « roi en échec ».
- Les gaffes sont peu profondes : 73 % sont visibles à 4 demi-coups ou moins.
Ni représentation manquante, ni calcul hors de portée : un défaut de sélection. Le modèle a la bonne réponse sous les yeux et prend la mauvaise, parce qu'il joue le coup le plus probable et pas le meilleur.
Il restait à chiffrer ce que valait un bon sélecteur avant de construire quoi que ce soit. On laisse Stockfish choisir parmi le top-5 du modèle :
| Sélecteur | Gaffes | Elo contre le modèle seul (2 000 parties) |
|---|---|---|
| le modèle seul | 18,3 % | 0 |
| Stockfish, profondeur 1 | 14,9 % | +127 |
| Stockfish, profondeur 4 | 11,9 % | +329 |
| Stockfish, profondeur 12 | 5,1 % | +599 |
Le plafond de la sélection valait 600 Elo, avec les coups que le modèle propose déjà. Il fallait maintenant un juge qui ne soit pas Stockfish.
10Ce qui a marché, étape 1 : un juge
Un juge sur . Une petite tête lit l'état interne du 142 M après chaque coup candidat et prédit s'il est bon, entraînée sur 1,5 M de candidats notés par Stockfish. On combine sa note avec la probabilité du coup (le prior de la corrige la « » : un évaluateur bruité maximisé sur plus de candidats finit par choisir celui qu'il surestime).
juge (top-5, alpha 0,5) contre le modèle seul, 2 000 parties
écart d'Elo : +51,8  [+38,3 ; +65,5]
Premier gain reproductible sur le 142 M depuis des semaines. Mais seulement 9 % du plafond.
Et une découverte embarrassante. Les dumps Lichess contiennent déjà des annotations Stockfish pour toutes les parties que leurs joueurs ont fait analyser, et mon script de préparation des données les supprimait depuis le premier jour du projet. Sur quatre mois : 454 millions d'évaluations gratuites, l'équivalent de 1 052 heures de Stockfish sur 12 cœurs.
Un vrai . Au lieu d'une petite tête sur un tronc gelé, on affine une copie complète du 142 M pour noter les positions, sur 67,8 millions de ces évaluations. La politique n'est pas touchée : deux transformeurs, la même architecture, l'un pour l'intuition, l'autre pour le jugement.
Il faut le dire clairement : ces évaluations sont celles de Stockfish, calculées par Lichess. Le juge n'appelle jamais Stockfish, mais il a appris à noter les positions comme lui. Stockfish est distillé dans le juge. La politique, elle, n'a toujours appris que de coups humains.
politique + valeur (top-5, alpha 0,25) contre le modèle seul, 2 000 parties
1163 victoires, 389 nulles, 448 défaites
écart d'Elo : +129,9  [+115,8 ; +144,5]
Le niveau de Stockfish profondeur 1, sans appeler Stockfish pendant la partie : deux passes avant par coup. Déployé sur le bot le 25 septembre au soir.
11Ce qui a marché, étape 2 : une recherche
Avec une politique qui propose et une valeur qui juge, on a exactement les deux ingrédients d'AlphaZero. La recherche est de type : la politique donne les a priori sur le top-5, la valeur note chaque feuille, le coup joué est le plus visité. Réglage fait sur les positions du bot, publication sur le diagnostic, jamais l'inverse.
Hors ligne, à 64 : 11,6 % de gaffes, au niveau de Stockfish profondeur 4, avec uniquement des passes du transformeur, sans appeler Stockfish et sans aucune évaluation écrite à la main. En partie :
recherche 64 sim. contre politique + valeur (le moteur du bot), 1 000 parties
863 victoires, 74 nulles, 63 défaites
écart d'Elo : +381,7  [+351,8 ; +416,3]
Déployée sur le bot le 26 septembre à 3 h du matin. Puis la suite, chaque ligne mesurée contre la précédente :
| Moteur du bot | Contre le précédent |
|---|---|
| modèle seul (jusqu'au 25/09) | |
| politique + valeur v1 | +129,9 [+115,8 ; +144,5] |
| recherche 64 simulations + v1 | +381,7 [+351,8 ; +416,3] |
| recherche 64 simulations + valeur v2 (412 M de cibles) | +37,0 [+17,4 ; +56,8] |
| recherche 256 contre 64 simulations | +415,6 [+368,2 ; +477,1] |
Quatre fois plus de simulations valent +416 Elo, autant que le passage de la sélection à la recherche. Le bot, qui jouait à 64 simulations et laissait 85 % de sa pendule inutilisée, avait une marge énorme. À 1 024 simulations, hors ligne, le taux de gaffes descend à 6,9 %, le niveau de Stockfish profondeur 8.
Attention à la lecture : ces écarts sont mesurés contre ses propres versions, ce qui gonfle en général les écarts face à des adversaires variés, et l'Elo n'est pas parfaitement transitif. Seul le classement Lichess tranche.
Ce qu'il a fallu construire autour
Passer de 23 ms à plusieurs secondes par coup sur un bot qui joue jusqu'à 50 parties simultanées, sur une RTX 3060, n'est pas gratuit.
- La pendule transmise au moteur. Le client relaie désormais le temps restant et l'incrément.
- Réfléchir au milieu de partie, pas dans l'ouverture. Mesuré sur 6,26 M de positions : le juge contredit l'intuition 11 % du temps dans l'ouverture, 22 % au milieu de partie, et y rapporte trois fois plus. L'ancien budget faisait l'inverse. Le nouveau pondère par phase et vise ~80 % de la pendule, en descendant jusqu'à une seule passe avant quand le temps manque.
- Une recherche interruptible. Le serveur traite les coups un par un : une recherche de 11 s aurait fait attendre un coup de bullet arrivé entre-temps. La recherche s'arrête si une autre partie attend depuis plus que sa patience.
- . Le coût était dans le lancement des opérations depuis Python, pas dans le GPU. Chaque forme de passe est enregistrée une fois et rejouée d'un appel : ×2 à nombre de simulations égal, 1 024 simulations en ~3 s sur la 3060.
- Un plafond de simulations modifiable à chaud par fichier, pour ajuster sans redémarrer le bot.
12Ce qui n'a pas marché de ce côté-là non plus : distiller la recherche
Si la recherche trouve de meilleurs coups, pourquoi ne pas les réapprendre à la politique, pour qu'elle les joue d'intuition en une passe ? C'est l' d'AlphaZero. Trois versions :
| Version | Maître | Résultat |
|---|---|---|
| B1 | le sélecteur politique + valeur, 6,26 M positions, cible douce | −0,8 point de gaffes, rien en duel ; la politique s'aplatit |
| B2 | même maître, cible presque dure | −1,2 point, accord 81 → 83 %, rien de visible |
| B3 | la recherche elle-même, 100 000 positions | accord avec le maître en baisse (73 → 71 %) |
En une passe, la politique ne reproduit pas ce que le juge calcule sur la position d'après, ni ce que la recherche calcule plusieurs coups plus loin. Le gain est dans la recherche au moment de jouer, pas dans les poids.
13La plomberie, qui a coûté plus de temps que les idées
Aucune de ces pannes n'était dans le modèle, et toutes ont coûté des heures.
- J'ai fait bannir mon propre bot. Des redémarrages en rafale avaient laissé ~47 processus orphelins qui tenaient le flux Lichess ouvert ; Lichess n'en autorise qu'un par compte.
429pendant 19 heures. Correctif : le tue désormais le groupe de processus, et ne redémarre que sur un vrai crash. - Deux cartes, mêmes poids, aucun hasard : elles jouent différemment. En , 2 positions sur 500 changent de coup entre la 3090 et la 3060, parce que le pas de quantification (1/16) tombe pile sur des quasi-égalités. En fp32, zéro. Règle : les deux bras d'un A/B sur la même carte.
- Une mise à jour automatique du pilote NVIDIA sous les calculs. Les processus en cours survivent, les nouveaux échouent : run4 aurait fini ses vingt heures, puis ses trois duels seraient morts, et le bot au premier redémarrage. Contourné sans rien casser par une garde qui recharge la bonne bibliothèque.
- Un champ
vocab_sizenon mis à jour en ajoutant 19 jetons :device-side assertde CUDA sans explication, sur un seul des deux bras de l'A/B. Sept heures et demie perdues. - Une perte devenue en entraînant la valeur v2 :
clip_grad_norm_ne protège pas d'un NaN, il multiplie tout par NaN. Les pas non finis sont désormais sautés. - Le à gauche par
<bos>dans un calcul par lots : le taux de gaffes mesuré passait de 18 % à 52 % et la conclusion du diagnostic s'inversait. Démasqué uniquement parce que deux chemins de code donnaient des chiffres différents.
Le point commun : un échec qui ne ressemble pas à un échec.
14Le résultat sur Lichess
Le classement Lichess reste le seul Elo absolu du projet : public, contre des adversaires que je n'ai pas choisis, sur des parties que tout le monde peut rejouer.
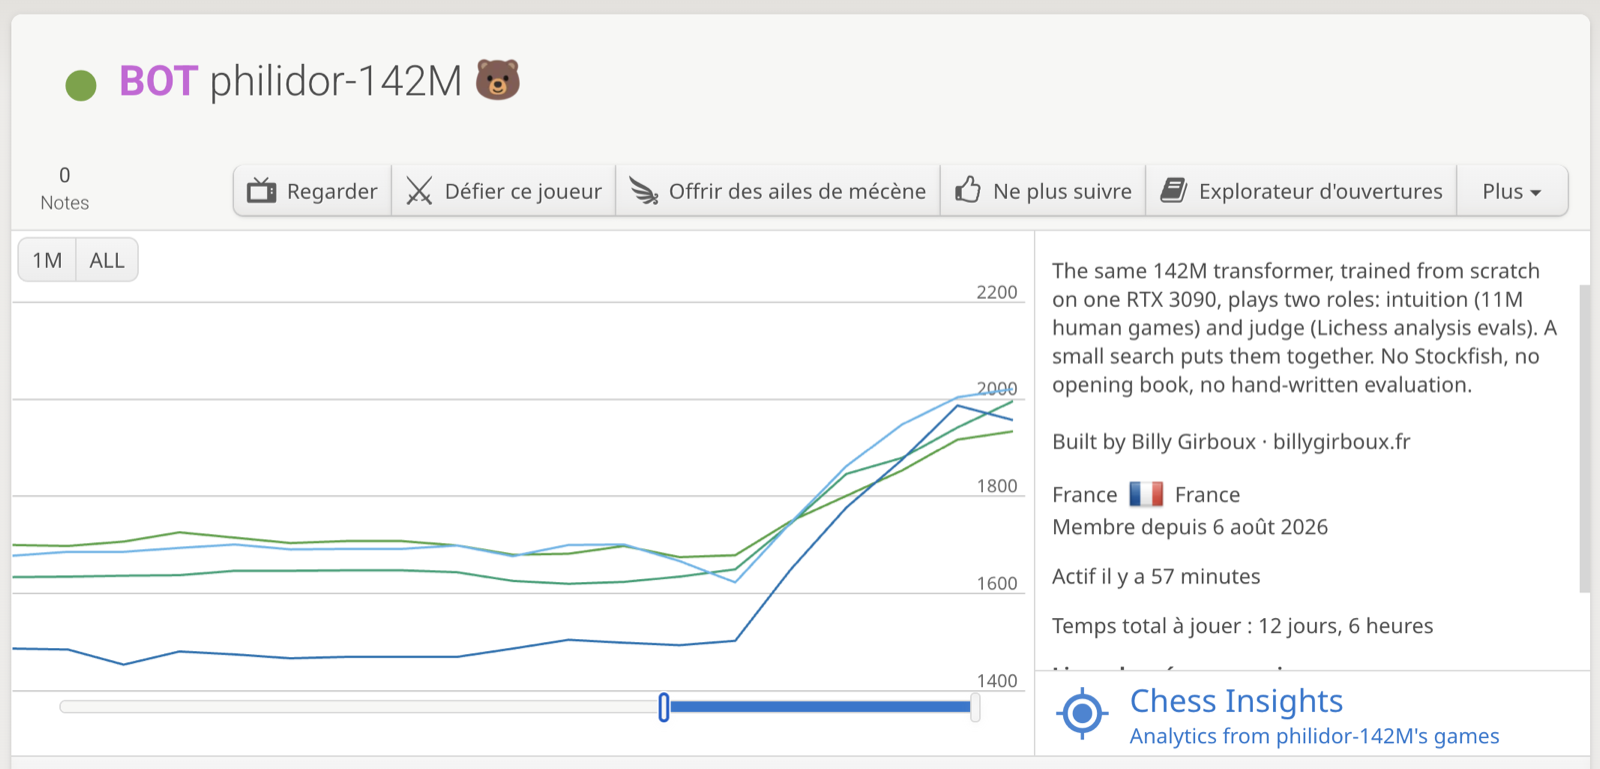
| Date | Moteur | Bullet | Blitz | Rapide | Classique |
|---|---|---|---|---|---|
| 9 août | modèle seul | 1646 | 1671 | 1702 | — |
| 14 août | modèle seul | 1681 | 1544 | 1719 | — |
| 7 sept. | modèle seul | — | 1478 | 1631 | 1730 |
| 26 sept., 9 h 30 | recherche depuis quelques heures | 1626 | 1501 | 1662 | 1682 |
| 26 sept., 19 h 30 | recherche 1 024 simulations | 1711 | 1595 | 1715 | 1700 |
| 30 sept. | recherche + graphes CUDA | 2020 (1 478 p.) | 1975 (1 668 p.) | 1996 (906 p.) | 1930 (395 p.) |
Par rapport au plateau d'août et de début septembre :
| Cadence | Modèle seul | Avec juge et recherche | Écart |
|---|---|---|---|
| Bullet | 1646 (9 août) | 2020 | +374 |
| Blitz | 1671 (9 août) | 1975 | +304 |
| Rapide | 1702 (9 août) | 1996 | +294 |
| Classique | 1730 (7 sept.) | 1930 | +200 |
C'est cohérent avec la fourchette que je m'étais donnée le 26 septembre, avant d'avoir le moindre classement : les +550 cumulés en duels contre ses propres versions devaient se traduire par +250 à +500 face à des adversaires variés. On y est, dans le bas de la fourchette, pour trois cadences sur quatre, et c'est un classement public, établi sur plus de 4 000 parties.
Deux détails qui méritent d'être notés. Le bullet est désormais sa meilleure cadence, alors que c'est là qu'il a le moins de temps pour chercher : le budget par phase concentre le peu de temps disponible sur le milieu de partie, là où la réflexion rapporte le plus, et la recherche interruptible évite qu'une longue réflexion dans une autre partie lui coûte sa pendule. Et le classique progresse moins (+200) : c'est la cadence où il joue le moins, donc celle où le classement a eu le moins de parties depuis le 26 septembre pour rattraper son nouveau niveau. C'est pourtant là que la recherche a le plus de temps, jusqu'à 1 024 simulations par coup ; son classement devrait continuer à monter.
Pendant les premières heures à 1 024 simulations : 15 victoires et 1 défaite en 16 parties, contre des adversaires jusqu'à 2014, aucune défaite au temps, 60 à 88 % de la pendule utilisée dans les parties longues.
Le même transformeur de 142 M, les mêmes poids qu'en août pour la politique. Stockfish n'est jamais appelé pendant une partie et aucune évaluation n'est écrite à la main. Mais le juge a appris ses notes sur des évaluations Stockfish : Stockfish n'est pas dans le bot, il est distillé dans le juge.
15Ce que ça coûte à la démonstration
L'argument d'origine du projet était qu'un modèle de langage seul, sans arbre de recherche, sans livre d'ouvertures, sans fonction d'évaluation, tenait 1700 face à des humains. En août, j'écrivais : « ajouter une recherche gagne des points et perd la démonstration. »
C'est exactement ce qui s'est passé, et je préfère le dire franchement. Le bot actuel n'est plus un modèle de langage pur. C'est le même transformeur, utilisé comme intuition et comme juge, avec une recherche autour, et le juge a appris de Stockfish. philidor-142M seul, en une passe, joue toujours exactement comme avant, et la démonstration d'août tient toujours pour lui.
Mais la route pour arriver là a répondu à une question plus intéressante que « combien d'Elo ». Elle a montré pourquoi un pur prédicteur de coups plafonne : il a l'échiquier en tête, il a le bon coup dans son top-5, il gaffe au même rythme que les humains dont il a appris, et il ne peut pas faire mieux parce qu'il n'a aucun canal pour juger. Toutes les tentatives de lui faire exprimer un jugement dans son flux de coups ont échoué. Dès qu'on lui a donné un juge et du temps pour s'en servir, il a progressé de plusieurs centaines de points.
16Ce que j'en retiens
Regarder comment le système échoue avant de chercher à l'améliorer. Six semaines d'hypothèses sur le « plafond à 1700 », et la réponse était dans ses parties perdues : 93 % de défaites sur une seule gaffe. La moyenne n'était pas le problème.
Chiffrer le plafond d'une idée avant de la construire. Laisser Stockfish choisir dans le top-5 du modèle a coûté une nuit et a dit : 600 Elo sont là. Aucune des pistes précédentes n'avait eu cette mesure préalable.
Un banc d'essai qui ne sait pas rendre zéro n'a aucune autorité sur un écart de 5 %. Le témoin clone coûte dix lignes.
Ne jamais valider par auto-affrontement une méthode qui modélise l'adversaire. Le +449 de l'anticipation valait zéro contre Stockfish.
Un témoin « avec et sans X » ne vaut que si le modèle a connu les deux régimes. Sinon on mesure une sortie de distribution.
Ce qui aide un petit modèle n'aide pas forcément un gros. Les coups du gagnant (+49 à 51 M) et le conditionnement (+11 à 10,5 M) ont disparu à 142 M. Toujours vérifier à l'échelle où l'on déploie.
Relire ce qu'on jette. 454 millions d'évaluations Stockfish supprimées par une expression régulière depuis le premier jour.
Un meilleur prédicteur n'est pas un meilleur joueur. Faire mieux imiter Stockfish a amélioré l'accord et pas l'Elo. Juger et chercher, si.
§Annexe : toutes les tentatives, en un tableau
| Tentative | Modèle | Résultat | Statut |
|---|---|---|---|
| Température 0,3 au lieu de 0 | 142 M | aucun effet (300 parties/cellule) | abandonné |
| Grossir 51 M → 142 M (et ×4 données) | — | +285 | ✅ déjà acquis en août |
| Sur-échantillonner les finales | — | faux diagnostic, pas lancé | abandonné |
| Relever le filtre Elo | — | corpus ÷2,6 à ÷9, pas lancé | abandonné |
| Réflexion v1 (fine-tuning) | 142 M | −413 | ❌ |
| Réflexion v2 (trois candidats) | 142 M | −241 | ❌ |
| Réflexion entraînée de zéro | 51 M | −275 | ❌ |
| Réflexion + RL par rejet | — | score ÷3 contre Stockfish | ❌ |
| Anticipation 8 demi-coups + matériel | 142 M | +449 en auto-affrontement, ~0 contre Stockfish | ❌ artefact |
| DAgger naïf / masqué | 51 M | −49 / −63 | ❌ |
| DAgger diversité maximale | 51 M | +4,6 pts d'accord, −23 Elo (ns) | ❌ |
| Données uniques au lieu de répétées | 51 M | −8,7 à budget égal (ns) | ❌ |
| Coups du gagnant | 51 M / 142 M | +49 / +9,6 (ns) | ❌ ne transfère pas |
| Échelle vers le bas (0,5 à 22 M) | — | ~110 Elo par doublement | 📏 mesure |
| Raisonnement latent (boucle) | 8,5 M / 27 M | −91 contre un modèle simple | ❌ |
| Tête auxiliaire échiquier | 10,5 M | +14,8 (ns) | ❌ |
| Tête auxiliaire valeur | 10,5 M | −47 | ❌ |
| Conditionnement Elo / cadence / issue | 142 M | −2,4 et +8,7 (ns) | ❌ |
| Maître Stockfish au lieu d'humain | 10,5 M | −36 | ❌ |
| Variante principale de Stockfish | 10,5 M / 51 M | +60 / +246 à supervision égale, mais sous run1 | ⏸️ trop cher à 142 M |
| Lookahead évalué par log-probabilité | 142 M | −545 | ❌ |
| Juge sur tronc gelé | 142 M | +51,8 | ✅ |
Réseau de valeur (copie affinée, [%eval] Lichess) | 142 M | +129,9 | ✅ déployé |
| Recherche PUCT 64 simulations | 142 M | +381,7 | ✅ déployé |
| Valeur v2 (412 M cibles) | 142 M | +37,0 | ✅ déployé |
| Recherche 256 contre 64 simulations | 142 M | +415,6 | ✅ déployé |
| Budget de pendule par phase, recherche interruptible | 142 M | jusqu'à 1 024 sim., 0 défaite au temps | ✅ déployé |
| Graphes CUDA | 142 M | ×2 de vitesse | ✅ déployé |
| Itération experte B1 / B2 / B3 | 142 M | rien en duel | ❌ |
Le bot joue en continu et accepte les défis : lichess.org/@/philidor-142M.
§Glossaire
Le vocabulaire employé dans cet article, avec les chiffres réels du projet plutôt que des définitions abstraites. Dans le texte, les termes soulignés en pointillé ouvrent leur définition d'un clic.
Elo
Un système de classement où l'écart entre deux joueurs prédit le score attendu entre eux. 100 points d'écart, c'est environ 64 % des points pour le plus fort ; 400 points, environ 91 %.
Un Elo n'a de sens que relatif à un groupe d'adversaires. C'est pourquoi l'article distingue les écarts mesurés en duel, contre des versions du même bot, et le classement Lichess, établi contre des humains et des bots que je n'ai pas choisis.
Intervalle de confiance à 95 %
La fourchette dans laquelle se trouve vraisemblablement le vrai écart, compte tenu du nombre de parties jouées. +129,9 [+115,8 ; +144,5] se lit : l'écart mesuré est de +130, et le vrai écart a 95 chances sur 100 d'être entre +116 et +145.
Avec 200 parties, la fourchette fait facilement ±60 points. C'est la raison pour laquelle la plupart des duels de cet article en comptent de 1 000 à 3 000.
Significatif, non significatif (ns)
Un écart est significatif quand tout son intervalle de confiance est du même côté de zéro : on peut affirmer qu'il existe, dans le sens mesuré. Il est non significatif quand l'intervalle contient zéro : le résultat est compatible avec « aucun effet ».
Non significatif ne veut pas dire nul. Ça veut dire que la mesure ne permet pas de conclure, ce qui, pour une piste qui promettait des dizaines de points, revient à l'abandonner.
Ouvertures appariées
Chaque ouverture tirée au hasard est jouée deux fois, une fois avec chaque couleur. L'avantage d'une position de départ ou du trait s'annule alors exactement entre les deux camps, au lieu de se mélanger au résultat.
Sans cet appariement, mon banc d'essai rendait 41,67 % au lieu de 50 % pour un modèle contre lui-même.
Témoin clone
Faire jouer un modèle contre une copie exacte de lui-même. La seule réponse correcte est 50,00 %. Si le banc d'essai rend autre chose, c'est le banc qui est faux, pas le modèle.
C'est le contrôle le moins cher du projet, une dizaine de lignes, et celui qui a le plus de valeur : sans lui, aucun écart de quelques pourcents n'est crédible.
σ (sigma)
L'écart-type, l'unité naturelle du bruit d'une mesure. Un effet à 2,9 σ est presque trois fois plus grand que ce que le hasard produit habituellement : il est très probablement réel.
Auto-affrontement
Mesurer une version du bot contre une autre version du même bot. C'est rapide et reproductible, mais ça gonfle généralement les écarts, et ça devient franchement trompeur quand la méthode testée simule l'adversaire avec le même modèle : elle prédit alors parfaitement ses coups. L'anticipation a ainsi mesuré +449 contre elle-même, et environ zéro contre Stockfish.
Hors distribution
Une entrée d'un type que le modèle n'a jamais rencontré à l'entraînement. Son comportement y est imprévisible, et généralement mauvais. Retirer l'amorce de conditionnement à un modèle qui l'a toujours vue le met hors distribution : la perte de force mesurée vient de là, pas de l'absence d'information.
Paramètre
Un des nombres ajustables du modèle, fixés par l'entraînement. C'est la mesure usuelle de sa taille : 51 millions pour le premier modèle (run1), 142 millions pour celui du bot.
Transformeur
L'architecture de réseau de neurones de presque tous les modèles de langage actuels. Il lit une séquence de tokens et prédit le suivant, en laissant chaque position consulter toutes celles qui la précèdent. Celui de Philidor a 20 couches de largeur 768.
Token
L'unité que le modèle lit et écrit. Ici, un token est exactement un coup, par exemple e2e4. Le vocabulaire compte 1 968 coups géométriquement possibles et trois marqueurs, et aucun token ne signifie « bon » ou « mauvais » : c'est le fond du problème de toute la piste « réflexion ».
Passe avant
Un calcul complet du réseau, de l'entrée à la sortie. Philidor seul joue en une passe avant, 23 ms. La recherche en fait des centaines par coup, ce qui explique tout le travail de plomberie pour tenir la pendule.
Masque de légalité
Avant de choisir un coup, on met à zéro la probabilité de tous les coups illégaux dans la position. C'est la seule connaissance des règles ajoutée autour du modèle, qui n'en a jamais vu une.
Température
Le réglage qui décide comment on tire un coup dans la distribution prédite. À 0, on prend toujours le plus probable ; plus elle monte, plus on laisse de place aux coups moins probables. Mesurée sur 300 parties par cellule : aucun effet sur la force de Philidor.
run1, run2
Les deux premiers entraînements du projet, racontés dans le premier article. run1 : 51 M de paramètres. run2 : 142 M, quatre fois plus de tokens, et c'est le modèle du bot, philidor-142M.
Fine-tuning
Reprendre un modèle déjà entraîné et poursuivre son entraînement sur des données plus petites et plus ciblées. Rapide, mais on ne peut pas y greffer un comportement qui demanderait autant de données que l'entraînement d'origine : 6 millions de tokens de réflexion ne pèsent rien face à 3,19 milliards de coups directs.
Loss (fonction de perte)
Le nombre que l'entraînement cherche à faire baisser : ici, à quel point le modèle a été surpris par le coup réellement joué. Choisir sur quels coups elle porte, ceux du gagnant seulement, ceux du maître seulement, est un levier d'entraînement à part entière.
Conditionnement
Préfixer chaque partie d'informations qu'on pourra fixer au moment de jouer : ici l'Elo des deux joueurs, la cadence et l'issue. L'idée est de tout garder dans le corpus, puis de demander au modèle de jouer « comme un 2400 qui gagne ».
Sonde linéaire
Un classifieur minimal entraîné à lire une information dans les activations d'un réseau gelé. S'il y arrive, l'information y est présente sous une forme simple. C'est ainsi qu'on sait que Philidor retrouve chaque pièce de l'échiquier à 91 %, et qu'il « voit » une pièce en prise, alors que personne ne lui a montré d'échiquier.
AUC
L'aire sous la courbe ROC, une note de qualité d'un classifieur entre 0,5 (hasard) et 1 (parfait). 0,992 pour détecter une pièce en prise : l'information est quasiment parfaitement lisible dans le modèle.
Tête auxiliaire
Une petite sortie supplémentaire branchée sur le tronc du modèle, entraînée à une autre tâche que prédire le coup (lire l'échiquier, dire qui gagne), dans l'espoir que cette tâche annexe l'aide à mieux jouer. Elle prend de la capacité au modèle principal : chez un petit modèle, ça se paie.
Raisonnement latent
Faire « réfléchir » un modèle sans écrire de tokens, en repassant plusieurs fois dans les mêmes couches. Plus de tours, plus de calcul, avec les mêmes paramètres.
Lichess, et son classement
Le grand site d'échecs libre, où Philidor joue en continu comme compte bot. Son classement est le seul Elo absolu du projet : public, établi contre des adversaires variés, sur des parties que chacun peut rejouer.
Cadence
Le temps de réflexion d'une partie. Du plus rapide au plus lent : bullet (moins de 3 minutes), blitz (3 à 8 minutes), rapide (8 à 25 minutes) et classique. Lichess tient un classement séparé pour chacune.
Stockfish
Le moteur d'échecs libre de référence, très largement surhumain. Il sert ici d'adversaire calibré, de juge des coups (en centipions) et, dans une piste abandonnée, de professeur. Le bot ne l'appelle jamais pendant une partie, mais le juge a appris à noter les positions sur ses évaluations : Stockfish est distillé dans le juge.
Brider en nœuds
Limiter la recherche de Stockfish à un nombre fixe de positions examinées plutôt qu'à une durée. En temps, sa force dépend de la charge de la machine ; en nœuds, elle est identique à chaque partie.
Demi-coup
Un coup d'un seul camp. Aux échecs, un « coup » compte un coup des blancs et un coup des noirs ; 8 demi-coups font donc 4 coups de chaque côté.
Centipion
L'unité d'évaluation des moteurs : un centième de pion. Perdre 100 centipions en un coup, c'est offrir l'équivalent d'un pion à l'adversaire.
Gaffe
Dans cet article, un coup qui perd au moins 100 centipions par rapport au meilleur coup, selon Stockfish. Une gaffe fatale en perd plus de 400. 93 % des défaites du bot tenaient à une seule gaffe fatale.
Variante principale
La suite de coups qu'un moteur considère comme le meilleur jeu des deux camps depuis la position. C'est le « raisonnement » d'un moteur, écrit en coups.
UCI
Le protocole texte standard par lequel une interface d'échecs dialogue avec un moteur : elle lui envoie la position et la pendule, il répond par un coup.
[%eval]
L'annotation qu'ajoute Lichess dans le fichier d'une partie quand un joueur l'a fait analyser par Stockfish : une évaluation par coup. Les dumps en contenaient 454 millions, que mon script de préparation supprimait depuis le premier jour.
Dump Lichess
Lichess publie chaque mois l'intégralité des parties jouées sur le site, en fichiers compressés librement téléchargeables. Un mois pèse plusieurs dizaines de gigaoctets ; c'est la source unique des données du projet.
DAgger
Dataset Aggregation. On laisse l'élève jouer, un expert corrige les positions où il se retrouve, et on réentraîne sur ces corrections. L'idée : apprendre à se sortir des situations que ses propres erreurs créent, et qu'aucun bon joueur n'atteint.
RL par rejet d'échantillons
Une forme simple d'apprentissage par renforcement : on fait produire plusieurs réponses au modèle, on ne garde que celles qui ont obtenu un bon résultat, et on le réentraîne dessus. On ne lui dicte plus quoi penser, on récompense ce qui marche.
Itération experte, distillation
Réentraîner la politique à jouer d'emblée, en une passe, les coups que la recherche a trouvés, pour que l'intuition progresse. C'est la boucle d'AlphaZero. Ici elle n'a rien donné : ce que la recherche calcule plusieurs coups plus loin ne tient pas dans une passe.
Politique
Le modèle qui propose : pour une position, une probabilité pour chaque coup. C'est exactement ce que philidor-142M a appris à faire, l'intuition du joueur.
Top-5
Les cinq coups auxquels la politique donne les plus fortes probabilités. Dans 71,5 % de ses gaffes, le meilleur coup y figurait : le modèle avait la bonne réponse sous les yeux.
Tronc gelé
On garde le modèle existant sans modifier un seul de ses poids, et on n'entraîne qu'une petite tête branchée sur ses activations internes. Peu coûteux, mais la tête ne peut exploiter que ce que le tronc a déjà appris à représenter.
Réseau de valeur
Le modèle qui juge : pour une position, qui est en train de gagner. Ici, une copie complète du 142 M affinée sur des évaluations Stockfish tirées des dumps Lichess : 67,8 millions pour la v1, 412 millions pour la v2. Même architecture que la politique, autre métier.
Malédiction du vainqueur
Quand on choisit le meilleur parmi plusieurs candidats notés par un évaluateur imparfait, on tend à choisir celui dont la note est la plus surestimée. Plus il y a de candidats, plus l'effet est fort. Mêler la note du juge à la probabilité de la politique le tempère.
AlphaZero
Le programme de DeepMind (2017) qui a appris les échecs par lui-même. Ses deux ingrédients : un réseau qui propose des coups et un réseau qui juge les positions, combinés dans une recherche arborescente. Philidor a fini par en réunir les deux, à partir de parties humaines.
Monte-Carlo
Estimer la valeur d'une position en jouant des parties au hasard jusqu'au bout et en comptant les victoires. Sans réseau de valeur pour abréger les parties, il en faut un nombre inabordable : ~155 000 évaluations par coup ici.
PUCT
L'algorithme de recherche d'AlphaZero. À chaque simulation, il descend l'arbre en choisissant le coup qui équilibre deux choses : ce que la politique en pense a priori, et ce que les évaluations déjà faites en ont dit. Les coups prometteurs mais peu explorés sont favorisés. À la fin, on joue le coup le plus visité.
Simulation
Une descente dans l'arbre de recherche, qui s'arrête sur une position nouvelle, la fait noter par le réseau de valeur, et remonte la note. Chacune coûte des passes avant ; 1 024 simulations prennent environ 3 s sur la RTX 3060.
Graphes CUDA
Un mécanisme NVIDIA qui enregistre une suite d'opérations GPU une fois, puis la rejoue d'un seul appel. Quand chaque opération est petite, le temps passé à les lancer une à une depuis Python domine ; les graphes le suppriment. Ici : deux fois plus de simulations dans le même temps.
bf16, fp32
Deux formats de nombres à virgule. fp32 utilise 32 bits ; bf16 en utilise 16, deux fois plus rapide et deux fois moins gourmand, au prix de la précision. Deux coups quasi égaux peuvent alors s'inverser selon la carte, puisque l'ordre exact des calculs diffère.
NaN
Not a Number : la valeur que produit un calcul impossible, comme 0/0. Elle contamine tout ce qu'elle touche, et un seul NaN suffit à ruiner les poids d'un modèle. Écrêter les gradients avec clip_grad_norm_ n'y change rien, puisqu'on multiplie alors tout par NaN.
Bourrage (padding)
Pour traiter plusieurs séquences de longueurs différentes en un seul lot, on complète les plus courtes avec un token neutre. Si ce token n'est pas correctement ignoré, le modèle voit un début de partie qui n'existe pas, et ses prédictions changent sans que rien ne plante.
Watchdog
Un petit programme qui surveille un service et le relance s'il tombe. Mal réglé, il relance aussi quand il ne faut pas, et empile des processus.
Le bot joue en continu et accepte les défis : lichess.org/@/philidor-142M. Code du projet : github.com/geekourson/philidor.